같은 모델, 두 개의 문 : Bedrock Mantle 엔드포인트와 bedrock-runtime을 도쿄 리전에서 실측 비교
Amazon Bedrock에는 추론 요청을 받는 엔드포인트가 두 개 있습니다. 예전부터 쓰던 bedrock-runtime.{region}.amazonaws.com과, OpenAI 호환 API와 Anthropic Messages API를 제공하는 bedrock-mantle.{region}.api.aws입니다. AWS 공식 문서는 두 엔드포인트가 같은 Mantle 추론 엔진 위에서 동작하며 bedrock-mantle이라는 이름은 엔진이 아니라 엔드포인트 표면을 가리킨다고 설명합니다. 그렇다면 “같은 모델을 같은 리전에서 호출할 때 응답 속도도 같은가”라는 질문이 자연스럽게 생깁니다. 이 글은 그 질문을 문서가 아니라 실측으로 확인합니다.
만들 것은 도쿄 리전(ap-northeast-1)에서 같은 모델을 두 엔드포인트로 번갈아 호출해 지연 시간을 비교하는 벤치마크입니다. Bedrock API 키, 두 엔드포인트의 URL과 모델 ID 표기 차이, IAM 액션 네임스페이스 차이, 쿼터 구조 차이를 거치게 됩니다. 어떤 기능을 어디에 사용했는지는 글 마지막에 표로 정리해두었습니다.
만들 것은 도쿄 리전(ap-northeast-1)에서 같은 모델을 두 엔드포인트로 번갈아 호출해 지연 시간을 비교하는 벤치마크입니다. Bedrock API 키, 두 엔드포인트의 URL과 모델 ID 표기 차이, IAM 액션 네임스페이스 차이, 쿼터 구조 차이를 거치게 됩니다. 어떤 기능을 어디에 사용했는지는 글 마지막에 표로 정리해두었습니다.
실습 환경
| 항목 | 내용 |
|---|---|
| 배포 대상 | AWS ap-northeast-1 (도쿄), IAM 리소스만 생성 |
| 런타임 요건 | Terraform 1.15.8, AWS Provider 6.62.0, openai 3.6.0, anthropic 1.2.0, boto3 1.42 |
| 비교 모델 | gpt-oss-120b (Chat Completions API), Claude Haiku 4.5 (Anthropic Messages API) |
| 측정 시각 | 2026-09-01 (KST 오후) |
목표 아키텍처
이 실험의 핵심은 “조건을 최대한 같게 맞추는 것”입니다. 같은 리전, 같은 모델, 같은 프롬프트, 같은 API 키, 같은 클라이언트 PC에서 엔드포인트 호스트 이름만 바꿔 호출해야 두 엔드포인트의 차이만 남습니다. 그래서 별도 서버를 두지 않고 개발자 PC에서 직접 호출하는 구성을 택했습니다.
배포 모델은 단순합니다. AWS 쪽에 만드는 리소스는 IAM 사용자 하나, 그 사용자에게 붙는 인라인 정책 하나, 그리고 그 사용자에게 발급되는 Bedrock 장기 API 키 하나뿐입니다. Bedrock 장기 API 키는 실체가 IAM 서비스 전용 자격 증명(service-specific credential)이므로 Terraform의 aws_iam_service_specific_credential 리소스로 만들 수 있습니다. 벤치마크 스크립트는 이 키 하나로 두 엔드포인트를 모두 호출합니다. 두 엔드포인트 모두 Bedrock API 키 인증을 지원하기 때문입니다.
호출 대상은 도쿄 리전의 두 엔드포인트입니다. bedrock-runtime은 OpenAI 호환 API를 /openai/v1 경로에, Anthropic Messages API를 /anthropic 경로에 제공합니다. bedrock-mantle은 OpenAI 호환 API를 /v1 경로에, Messages API를 /anthropic/v1/messages에 제공합니다. 두 엔드포인트 뒤에는 같은 Mantle 추론 엔진이 있고, 지표는 각각 AWS/Bedrock과 AWS/BedrockMantle 네임스페이스로 CloudWatch에 발행됩니다.
한 가지 비대칭이 있습니다. gpt-oss-120b는 두 엔드포인트 모두 도쿄 in-region으로 제공되지만, Claude Haiku 4.5는 bedrock-runtime에 도쿄 in-region 모델 ID가 없고 Geographic Inference Profile(도쿄와 오사카 사이 라우팅)로만 호출할 수 있습니다. 반면 bedrock-mantle은 크로스리전 추론이 없고 요청한 리전에서 처리가 끝납니다. 따라서 Claude 비교는 “in-region 대 Geographic Inference Profile” 비교라는 점을 감안해서 읽어야 합니다.
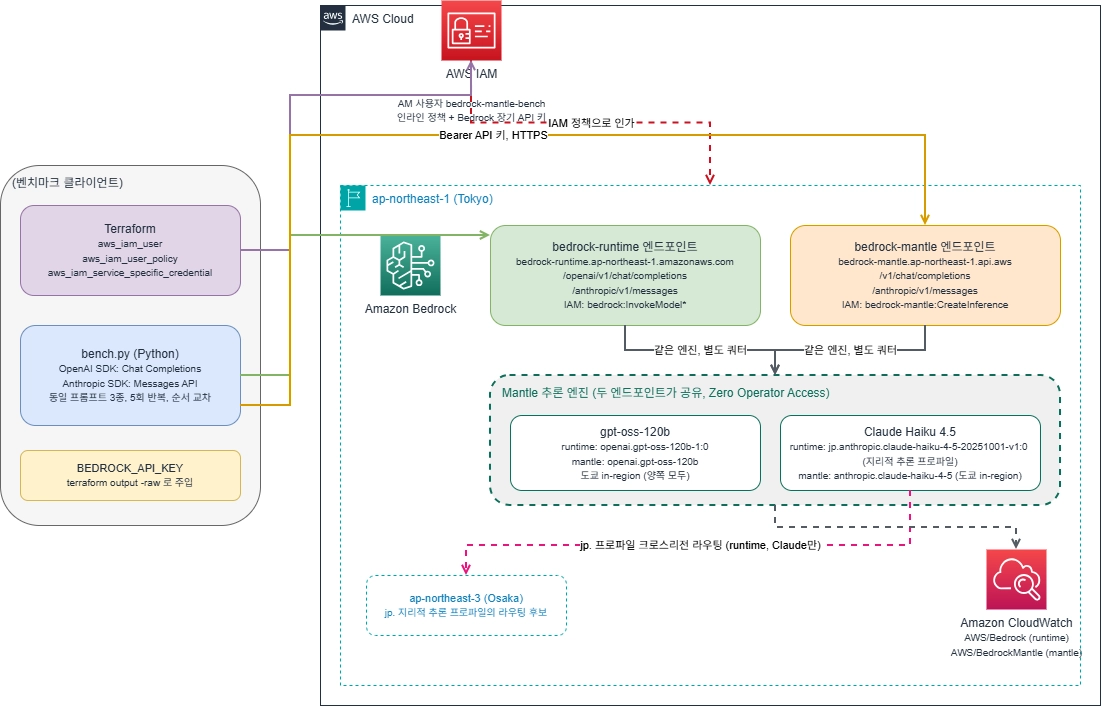
다이어그램의 구성 요소는 다음과 같습니다.
| 구성 요소 | 역할 |
|---|---|
| AWS IAM | 사용자 bedrock-mantle-bench와 API 키 보관 |
| bedrock-runtime 엔드포인트 | bedrock-runtime.ap-northeast-1.amazonaws.com |
| bedrock-mantle 엔드포인트 | bedrock-mantle.ap-northeast-1.api.aws |
| Mantle 추론 엔진 | 두 엔드포인트가 공유하는 추론 엔진, Zero Operator Access 설계 |
| gpt-oss-120b | 비교 모델 1 |
| Claude Haiku 4.5 | 비교 모델 2 |
| ap-northeast-3 (오사카) | jp. 지리적 추론 프로파일의 라우팅 후보 리전 |
| Amazon CloudWatch | 두 엔드포인트의 호출 지표 |
표에서 눈여겨볼 점은 AWS 쪽에 생성되는 리소스가 IAM 세 개뿐이라는 것입니다. 엔드포인트, 엔진, 모델은 모두 AWS가 관리하는 서비스이므로 만들거나 지울 것이 없고, 비용은 호출한 토큰만큼만 발생합니다.
한 회차의 실행 시퀀스를 그려보면 다음과 같습니다.
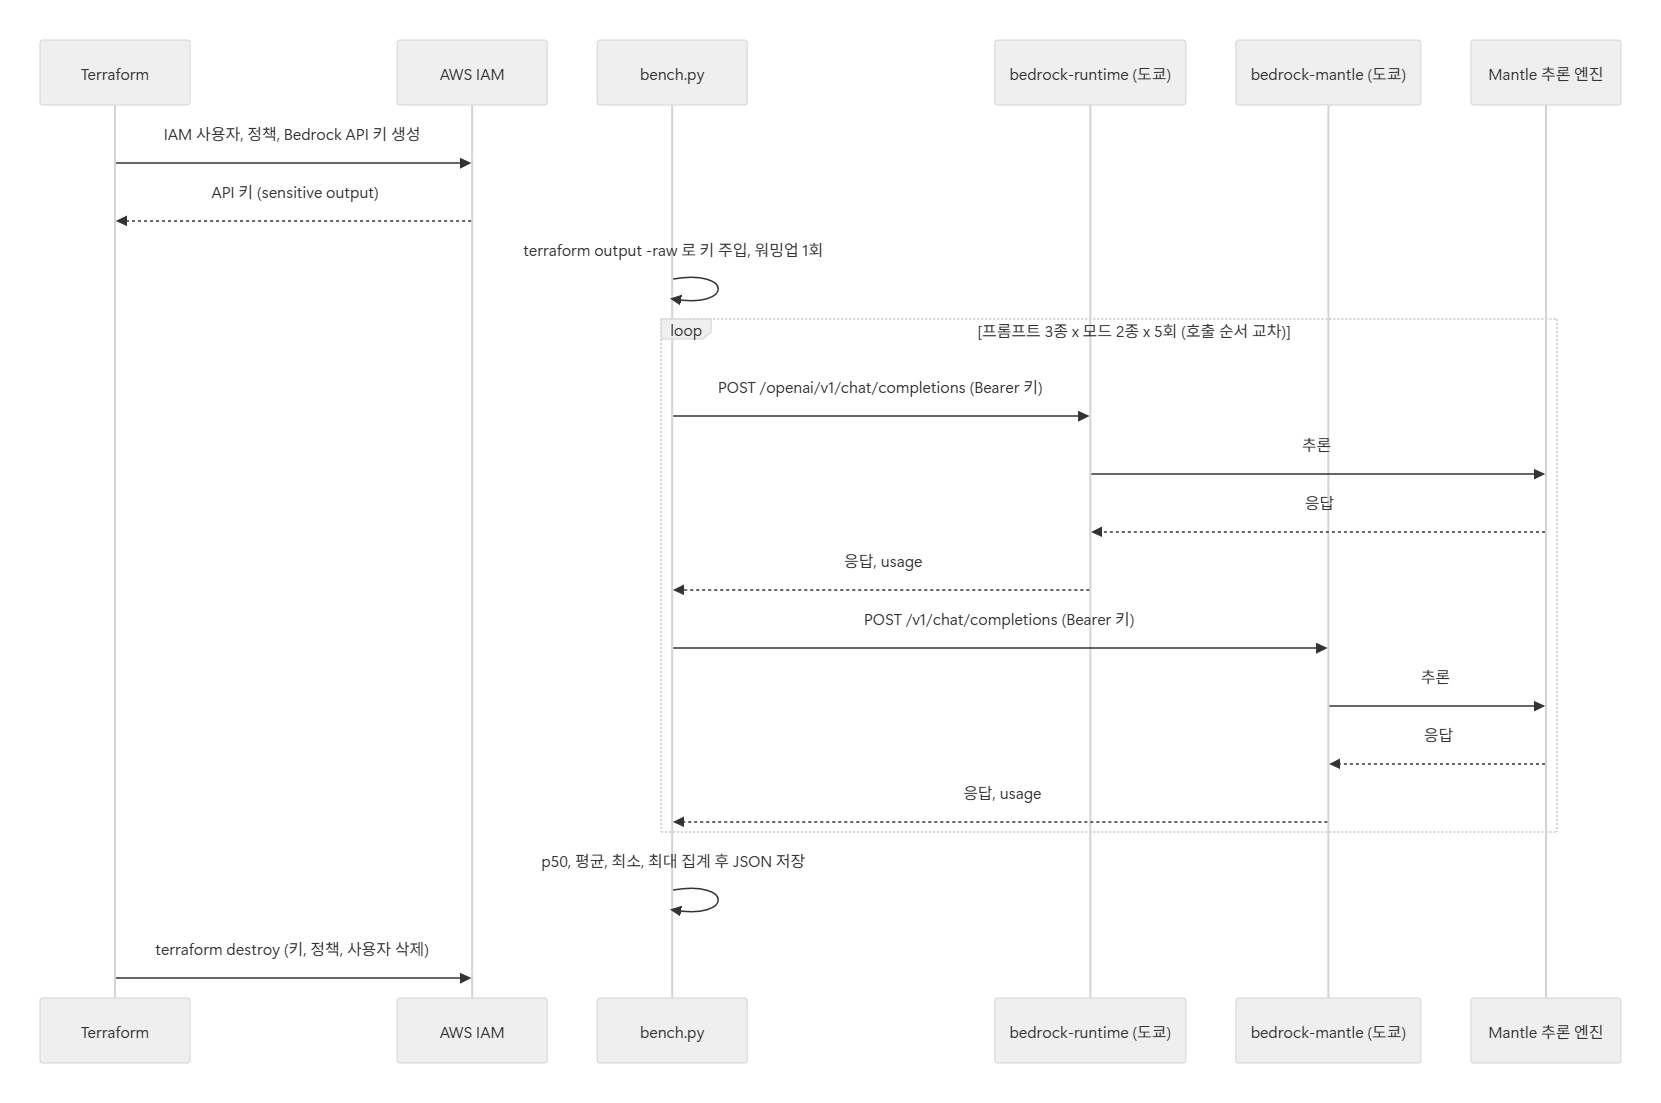
시퀀스에서 중요한 것은 두 엔드포인트가 같은 엔진으로 들어간다는 점과, 회차마다 호출 순서를 바꿔 특정 엔드포인트가 항상 먼저 호출되는 편향을 줄인다는 점입니다.
Step 1. Terraform으로 실측용 IAM 사용자와 Bedrock API 키 만들기
이 단계에서는 두 엔드포인트를 모두 호출할 수 있는 최소 권한의 IAM 사용자와 Bedrock 장기 API 키를 Terraform으로 만듭니다. 실측이 끝나면 통째로 지울 수 있도록 리소스를 한 곳에 모으는 것이 목적입니다.
먼저 API 키가 왜 필요한지부터 짚겠습니다. OpenAI SDK는 AWS SigV4 서명을 모릅니다. 그래서 OpenAI SDK로 Bedrock을 호출하려면 Bearer 토큰 형태의 Bedrock API 키가 필요합니다. API 키는 두 종류입니다. 단기 키는 최대 12시간 유효하고 생성한 IAM 주체의 권한을 상속하며, 장기 키는 IAM 사용자에 붙는 서비스 전용 자격 증명으로 만료일을 정할 수 있습니다. 공식 문서는 장기 키를 탐색 용도로만 권장합니다. 이 실험은 몇 시간 안에 끝나고 끝나는 즉시 지우므로 장기 키를 만료 1일로 만들었습니다.
Bedrock API 키를 만드는 경로는 세 가지입니다.
| 발급 경로 | 적합한 상황 | 명령 또는 방법 |
|---|---|---|
| 콘솔 | 한 번 써보고 버릴 때 | Bedrock 콘솔 > API keys > Long-term API keys > Generate |
| AWS CLI | 스크립트에서 즉석 발급 | aws iam create-service-specific-credential --user-name <user> --service-name bedrock.amazonaws.com --credential-age-days <days> |
| Terraform (이번 사례) | 사용자, 정책, 키를 한 단위로 만들고 지울 때 | aws_iam_service_specific_credential 리소스, credential_age_days 인자 |
Terraform 구성은 다음과 같습니다. 정책에는 bedrock-runtime용 액션과 bedrock-mantle용 액션을 별도 Statement로 나눠 넣었습니다. 두 엔드포인트의 IAM 액션 네임스페이스가 다르기 때문입니다.
terraform {
  required_version = ">= 1.5.0"
  required_providers {
    aws = {
      source  = "hashicorp/aws"
      version = ">= 6.0"
    }
  }
}

provider "aws" {
  region = var.region   # 기본값 ap-northeast-1
}

resource "aws_iam_user" "bench" {
  name = "bedrock-mantle-bench"
  path = "/bench/"
}

# runtime과 mantle은 IAM 액션 네임스페이스가 다르다
resource "aws_iam_user_policy" "bench" {
  name = "bedrock-both-endpoints-inference"
  user = aws_iam_user.bench.name
  policy = jsonencode({
    Version = "2012-10-17"
    Statement = [
      {
        Sid    = "RuntimeEndpoint"
        Effect = "Allow"
        Action = [
          "bedrock:InvokeModel",
          "bedrock:InvokeModelWithResponseStream",
          "bedrock:CallWithBearerToken",
          "bedrock:ListFoundationModels",
          "bedrock:ListInferenceProfiles",
          "bedrock:GetInferenceProfile"
        ]
        Resource = "*"
      },
      {
        Sid    = "MantleEndpoint"
        Effect = "Allow"
        Action = [
          "bedrock-mantle:CreateInference",
          "bedrock-mantle:ListModels",
          "bedrock-mantle:CallWithBearerToken"
        ]
        Resource = "*"
      }
    ]
  })
}

# Bedrock 장기 API 키 = IAM 서비스 전용 자격 증명
resource "aws_iam_service_specific_credential" "bedrock_api_key" {
  service_name        = "bedrock.amazonaws.com"
  user_name           = aws_iam_user.bench.name
  credential_age_days = 1
  depends_on          = [aws_iam_user_policy.bench]
}

output "bedrock_api_key" {
  value     = aws_iam_service_specific_credential.bedrock_api_key.service_credential_secret
  sensitive = true
}
적용은 평소와 같습니다.
terraform init
terraform apply -auto-approve
# 벤치마크 스크립트에 키 전달 (PowerShell 예시)
$env:BEDROCK_API_KEY = (terraform output -raw bedrock_api_key)
실제 적용 결과 IAM 사용자, 인라인 정책, API 키 세 리소스가 만들어졌고 출력에는 키 ID와 만료 시각(생성 시각 + 1일)이 표시되었습니다. 키 본문은 sensitive 출력이라 화면에 나오지 않고 terraform output -raw로만 읽습니다.
여기서 막히기 쉬운 지점을 정리하면 다음과 같습니다.
| 증상 | 원인 | 조치 |
|---|---|---|
credential_age_days 인자를 모른다는 오류 | AWS Provider가 오래됨 | 최신 6.x로 올림 (이번 실습은 6.62.0). 이 인자는 Bedrock 키에만 유효 |
mantle 호출 시 403 bedrock-mantle:ListModels ... not authorized | bedrock:* 액션은 mantle 호출을 인가하지 않음 | 정책에 bedrock-mantle:CreateInference, bedrock-mantle:ListModels 추가 |
| Bearer 키로 호출 시 거부 | CallWithBearerToken 액션이 Deny 되어 있음 | bedrock:CallWithBearerToken과 bedrock-mantle:CallWithBearerToken 둘 다 확인 |
| 키를 잃어버림 | service_credential_secret은 생성 시점에만 조회 가능 | terraform state에 남아 있으므로 output -raw로 재조회, 아니면 리소스 재생성 |
이 단계가 끝나면 키 하나로 도쿄 리전의 두 엔드포인트를 모두 호출할 수 있습니다.
Step 2. 두 엔드포인트 연결 확인 — URL, 모델 ID, 권한이 어떻게 다른가
이 단계에서는 본격적인 측정에 앞서 각 엔드포인트에 한 번씩 호출해 URL, 모델 ID, 응답 형식이 어떻게 다른지 확인합니다. 벤치마크 결과를 해석하려면 이 차이를 먼저 알아야 합니다.
같은 모델이라도 두 엔드포인트에서 부르는 이름이 다릅니다. bedrock-runtime은 Bedrock 고유의 모델 ID(버전 접미사 포함) 또는 크로스리전 추론 프로파일 ID를 쓰고, bedrock-mantle은 접두사 없는 파운데이션 모델 ID를 씁니다. 다음 표는 이번 실험에서 실제로 동작한 조합입니다.
| 항목 | bedrock-runtime | bedrock-mantle |
|---|---|---|
| OpenAI 호환 base URL | https://bedrock-runtime.ap-northeast-1.amazonaws.com/openai/v1 | https://bedrock-mantle.ap-northeast-1.api.aws/v1 |
| Anthropic SDK base URL | https://bedrock-runtime.ap-northeast-1.amazonaws.com/anthropic | https://bedrock-mantle.ap-northeast-1.api.aws/anthropic |
| gpt-oss-120b 모델 ID | openai.gpt-oss-120b-1:0 (openai.gpt-oss-120b는 400 오류) | openai.gpt-oss-120b |
| Claude Haiku 4.5 모델 ID | jp.anthropic.claude-haiku-4-5-20251001-v1:0 (지리 프로파일) | anthropic.claude-haiku-4-5 |
| 인증 | Bedrock API 키 또는 SigV4 | Bedrock API 키 또는 SigV4 |
| 인가 액션 | bedrock:InvokeModel, bedrock:InvokeModelWithResponseStream | bedrock-mantle:CreateInference |
GET /models 응답 (도쿄) | UnknownOperationException | 정상 (bedrock-mantle:ListModels 필요) |
| 크로스리전 추론 | 지리, 글로벌 프로파일 지원 | 미지원, 요청 리전에서 처리 |
연결 확인 스크립트의 핵심은 다음과 같습니다. 두 SDK 모두 base URL과 API 키만 바꾸면 그대로 동작합니다.
import os
from openai import OpenAI
from anthropic import Anthropic

REGION = "ap-northeast-1"
KEY = os.environ["BEDROCK_API_KEY"]

# OpenAI 호환 Chat Completions
runtime = OpenAI(base_url=f"<https://bedrock-runtime>.{REGION}.amazonaws.com/openai/v1", api_key=KEY)
mantle  = OpenAI(base_url=f"<https://bedrock-mantle>.{REGION}.api.aws/v1", api_key=KEY)

for name, client, model in [("runtime", runtime, "openai.gpt-oss-120b-1:0"),
                            ("mantle",  mantle,  "openai.gpt-oss-120b")]:
    r = client.chat.completions.create(
        model=model, max_tokens=64,
        messages=[{"role": "user", "content": "Reply with exactly: pong"}],
        extra_body={"reasoning_effort": "low"},
    )
    print(name, repr(r.choices[0].message.content), r.usage)

# Anthropic Messages API
runtime_a = Anthropic(base_url=f"<https://bedrock-runtime>.{REGION}.amazonaws.com/anthropic", api_key=KEY)
mantle_a  = Anthropic(base_url=f"<https://bedrock-mantle>.{REGION}.api.aws/anthropic", api_key=KEY)

for name, client, model in [("runtime", runtime_a, "jp.anthropic.claude-haiku-4-5-20251001-v1:0"),
                            ("mantle",  mantle_a,  "anthropic.claude-haiku-4-5")]:
    r = client.messages.create(model=model, max_tokens=32,
                               messages=[{"role": "user", "content": "Reply with exactly: pong"}])
    print(name, repr(r.content[0].text), r.usage)
실행하면 네 호출이 모두 성공하는데, gpt-oss-120b의 응답 본문이 엔드포인트에 따라 다르게 옵니다. bedrock-runtime은 <reasoning>We need to output exactly "pong".</reasoning>pong처럼 추론 과정을 content 안에 태그로 포함해 돌려주고, bedrock-mantle은 pong만 돌려줍니다. 두 응답의 completion_tokens는 19로 같았습니다. 즉 모델이 생성한 토큰은 같고, 그것을 클라이언트에 어떻게 노출하느냐가 엔드포인트마다 다릅니다. 이 차이는 뒤의 지연 시간 해석에도 영향을 줍니다.
Anthropic SDK를 mantle에 붙일 때 한 가지 주의할 점이 있습니다. base URL을 https://bedrock-mantle.{region}.api.aws까지만 주면 SDK가 /v1/messages를 붙여 404가 납니다. mantle의 Messages API 경로는 /anthropic/v1/messages이므로 base URL에 /anthropic까지 포함해야 합니다.
요청이 어느 경로로 인가되고 처리되는지 흐름으로 정리하면 다음과 같습니다.
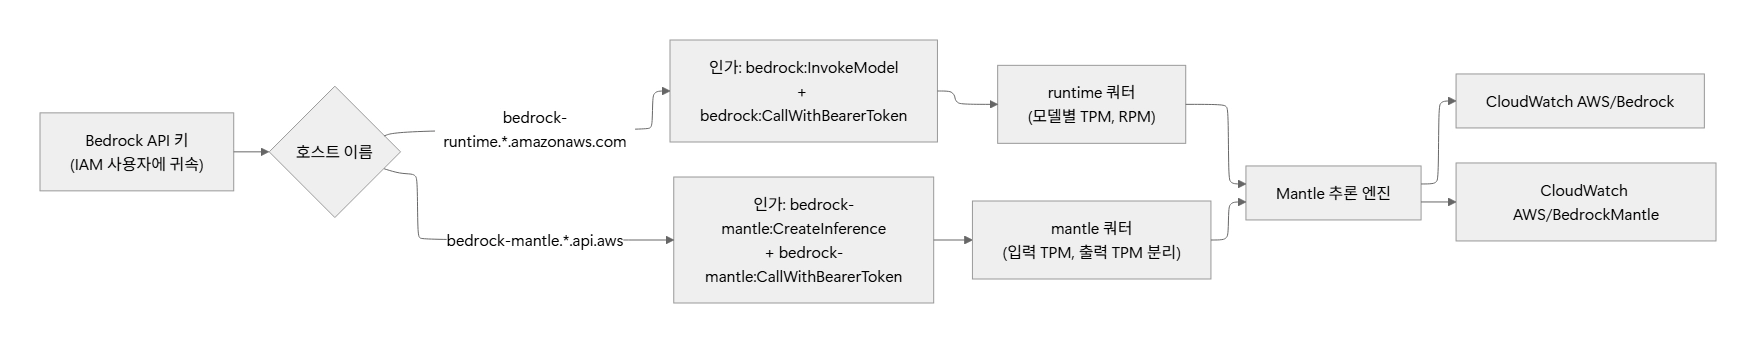
흐름에서 주목할 점은 인가와 쿼터가 호스트 이름 단계에서 갈라지고, 엔진에서 다시 합쳐진다는 것입니다. 이 단계가 끝나면 두 엔드포인트의 응답 형식과 권한 차이를 알고 벤치마크를 돌릴 수 있습니다.
Step 3. 벤치마크 스크립트 작성 — 무엇을 어떻게 재는가
이 단계에서는 측정 방법을 정합니다. 지연 시간 비교는 측정 방법이 조금만 달라도 결론이 뒤집히므로, 무엇을 재고 무엇을 통제했는지를 먼저 밝힙니다.
측정 지표는 네 가지입니다.
| 지표 | 정의 | 측정 모드 |
|---|---|---|
| E2E 지연 | 요청 전송부터 응답 객체 수신 완료까지 (ms) | 비스트리밍, 스트리밍 |
| TTFT | 요청 전송부터 첫 텍스트 델타 수신까지 (ms). 추론 토큰이 아니라 사용자에게 보이는 첫 글자 기준 | 스트리밍 |
| 출력 토큰 속도 | 출력 토큰 수 / (E2E – TTFT), 토큰/초 | 스트리밍 |
| 토큰 수 | 응답 usage의 입력, 출력 토큰 | 비스트리밍, 스트리밍 (OpenAI는 stream_options.include_usage, Anthropic은 message_delta 이벤트) |
통제한 조건은 다음과 같습니다.
| 조건 | 설정 | 이유 |
|---|---|---|
| 리전 | ap-northeast-1 고정 | 두 엔드포인트 모두 도쿄 in-region 제공 리전 |
| 모델 | gpt-oss-120b, Claude Haiku 4.5 | 두 엔드포인트에서 모두 제공되고 도쿄에서 호출 가능 |
| 프롬프트 | short(질문 한 문장), medium(로그 180줄), long(로그 1,400줄) | 프리필 비중이 다른 세 구간. 입력 토큰은 토크나이저에 따라 gpt-oss 98 / 8,045 / 61,715, Claude 37 / 9,112 / 70,398 |
max_tokens | 200 | 출력 길이 편차를 제한 |
gpt-oss reasoning_effort | low | 추론 토큰이 출력 한도를 다 쓰는 것을 방지 |
| 반복 | 프롬프트별, 모드별 5회, 회차마다 호출 순서 교차 | 순서 편향 완화 |
| 재시도 | max_retries=0, 실패 시 스크립트에서 최대 3회 | SDK 자동 재시도로 지연이 가려지지 않게 |
| 워밍업 | 엔드포인트당 1회, 결과 제외 | DNS와 TLS 핸드셰이크 비용 제거 |
medium과 long 프롬프트는 결정적으로 생성한 합성 운영 로그입니다. 로그 한 줄에 서비스 이름, 상태, p99 지연, CPU 사용률을 넣고, 그중 한 줄에만 INCIDENT-7731 root-cause=expired-tls-certificate를 심어 “몇 번 항목에 INCIDENT-7731이 있고 원인은 무엇인가”를 묻습니다. 모델이 프롬프트 전체를 실제로 읽어야 답할 수 있게 하기 위해서입니다.
def make_log(n_entries: int) -> str:
    lines = []
    for i in range(1, n_entries + 1):
        svc = SERVICES[i % len(SERVICES)]
        st = STATUSES[(i * 7) % len(STATUSES)]
        lat = 40 + (i * 37) % 900
        cpu = 5 + (i * 13) % 90
        lines.append(f"[entry {i:05d}] 2026-08-{(i % 28) + 1:02d}T{(i % 24):02d}:{(i * 3) % 60:02d}Z "
                     f"service={svc} status={st} p99_latency_ms={lat} cpu={cpu}% "
                     f"note=routine check by operator {chr(65 + i % 26)}{chr(65 + (i * 3) % 26)}")
    return "\n".join(lines)

# medium: 180줄에 97번 항목에 needle, long: 1400줄에 1123번 항목에 needle
스트리밍 측정부의 핵심은 다음과 같습니다. TTFT는 delta.content가 비어 있지 않은 첫 청크에서 찍습니다.
def stream(self, prompt):
    t0 = time.perf_counter(); ttft = None; out_tok = None
    s = self.c.chat.completions.create(
        model=self.model, max_tokens=self.max_tokens, stream=True,
        messages=[{"role": "system", "content": SYSTEM}, {"role": "user", "content": prompt}],
        stream_options={"include_usage": True},
        extra_body={"reasoning_effort": "low"},
    )
    for ch in s:
        if getattr(ch, "usage", None):
            out_tok = ch.usage.completion_tokens
        if ch.choices and ch.choices[0].delta and ch.choices[0].delta.content:
            if ttft is None:
                ttft = time.perf_counter() - t0
    dt = time.perf_counter() - t0
    return dict(e2e_ms=dt * 1000, ttft_ms=(ttft or dt) * 1000, out_tok=out_tok)
호출 순서 교차는 다음 한 줄로 처리합니다. 짝수 회차는 runtime을 먼저, 홀수 회차는 mantle을 먼저 호출합니다.
order = ("runtime", "mantle") if i % 2 == 0 else ("mantle", "runtime")
실행 명령은 다음과 같습니다. 두 모델은 서로 간섭하지 않도록 순차로 돌렸습니다.
python bench.py --suite gptoss --runs 5 --out results_gptoss.json
python bench.py --suite haiku  --runs 5 --out results_haiku.json
이 단계가 끝나면 엔드포인트별, 프롬프트별, 모드별 원시 데이터와 p50, 평균, 최소, 최대 요약이 JSON으로 남습니다.
Step 4. 실측 결과 — 같은 모델의 지연 비교
이 단계에서는 측정값을 읽습니다. 모든 수치는 2026-09-01 오후(KST)에 서울의 PC에서 도쿄 리전으로 호출한 값이며, 절대값보다 두 엔드포인트의 상대 차이에 주목하시기 바랍니다.
먼저 네트워크 바닥값입니다. 측정에 앞서 curl로 두 호스트의 DNS, TCP 연결, TLS 핸드셰이크 시간을 5회씩 쟀습니다.
| 호스트 | DNS (s) | TCP 연결 (s) | TLS 완료 (s) |
|---|---|---|---|
| bedrock-runtime.ap-northeast-1.amazonaws.com | 0.045 ~ 0.057 | 0.057 ~ 0.082 | 0.32 ~ 0.75 |
| bedrock-mantle.ap-northeast-1.api.aws | 0.044 ~ 0.141 | 0.084 ~ 0.163 | 0.31 ~ 1.57 |
첫 연결의 TLS 비용이 수백 ms로 큰데, 이는 두 엔드포인트 모두 같으므로 벤치마크에서는 워밍업 호출로 제거하고 커넥션을 재사용합니다.
gpt-oss-120b (Chat Completions API, 두 엔드포인트 모두 도쿄 in-region)
측정 구간은 2026-09-01T07:53Z ~ 07:55Z, 모델 ID는 runtime openai.gpt-oss-120b-1:0, mantle openai.gpt-oss-120b, max_tokens=200, reasoning_effort=low, 프롬프트별 모드별 5회입니다. 60회 호출 중 오류와 스로틀은 없었고, medium과 long의 needle 질문은 두 엔드포인트 모두 20회 중 20회 정답이었습니다.
비스트리밍 E2E 지연 (ms, 5회)
| 프롬프트 | 입력 토큰 | runtime p50 | runtime 평균 | runtime 최소~최대 | mantle p50 | mantle 평균 | mantle 최소~최대 | p50 차이 (mantle – runtime) |
|---|---|---|---|---|---|---|---|---|
| short | 98 | 591 | 591 | 471 ~ 668 | 641 | 644 | 604 ~ 707 | +49 (+8%) |
| medium | 8,045 | 1,073 | 1,259 | 650 ~ 2,471 | 851 | 807 | 674 ~ 961 | -222 (-21%) |
| long | 61,715 | 3,905 | 3,858 | 3,564 ~ 3,969 | 2,504 | 2,737 | 1,678 ~ 3,968 | -1,400 (-36%) |
스트리밍 TTFT와 E2E (ms, 5회)
| 프롬프트 | runtime TTFT p50 | runtime E2E p50 | runtime E2E 최소~최대 | mantle TTFT p50 | mantle E2E p50 | mantle E2E 최소~최대 | TTFT p50 차이 (mantle – runtime) |
|---|---|---|---|---|---|---|---|
| short | 992 | 1,049 | 765 ~ 4,309 | 566 | 654 | 539 ~ 880 | -426 (-43%) |
| medium | 905 | 938 | 836 ~ 1,020 | 782 | 783 | 568 ~ 869 | -122 (-14%) |
| long | 2,805 | 2,866 | 1,116 ~ 4,547 | 3,538 | 3,539 | 2,646 ~ 4,103 | +733 (+26%) |
출력 토큰 수와 스트리밍 청크 수 (p50)
| 프롬프트 | runtime 출력 토큰 | mantle 출력 토큰 | runtime 청크 수 | mantle 청크 수 |
|---|---|---|---|---|
| short | 46 | 43 | 2 | 2 |
| medium | 42 | 40 | 3 | 1 |
| long | 72 | 53 | 4 | 1 |
세 표에서 읽을 수 있는 것은 다음과 같습니다.
- 비스트리밍 p50은 short에서 mantle이 49ms 느리고, medium과 long에서는 mantle이 각각 222ms, 1,400ms 빠릅니다. 그런데 스트리밍에서는 long의 방향이 뒤집혀 runtime이 733ms 빠릅니다. 같은 프롬프트에서 모드에 따라 승자가 바뀐다는 것은, 두 엔드포인트의 차이가 회차 간 편차보다 작다는 뜻입니다. runtime long 스트리밍의 최소값 1,116ms와 최대값 4,547ms, mantle long 비스트리밍의 1,678ms와 3,968ms가 그 편차의 크기입니다.
- 가장 반복적으로 관측된 차이는 short 프롬프트의 TTFT입니다. mantle 566ms, runtime 992ms로 mantle이 400ms 남짓 빨랐습니다. 다만 runtime short 스트리밍에는 4,309ms짜리 이상치가 하나 있어 평균이 크게 흔들렸습니다.
- 청크 수가 1~4개입니다. gpt-oss-120b는
reasoning_effort=low에서도 추론을 먼저 끝낸 뒤 40~70 토큰짜리 답을 한두 청크로 한 번에 보내므로, TTFT가 E2E와 거의 같습니다. mantle은 추론 텍스트를 걷어내고 최종 답만 보내기 때문에 청크가 1개인 경우가 대부분입니다. 이 모델에서는 스트리밍을 켜도 사용자가 글자가 흘러나오는 것을 볼 수 없다는 뜻이고, 이는 두 엔드포인트가 같습니다. - long에서 같은 프롬프트를 반복하는 동안 양쪽 모두 간헐적으로 1.1~1.7초대의 빠른 응답이 섞여 나왔습니다. 응답
usage에 캐시 관련 필드가 없어 원인을 단정할 수 없으므로, 긴 프롬프트의 절대값은 참고로만 보시기 바랍니다.
Claude Haiku 4.5 (Anthropic Messages API, runtime은 jp. 지리적 추론 프로파일)
측정 구간은 2026-09-01T07:58Z ~ 08:00Z, 모델 ID는 runtime jp.anthropic.claude-haiku-4-5-20251001-v1:0(도쿄와 오사카 사이 지리적 추론 프로파일), mantle anthropic.claude-haiku-4-5(도쿄 in-region), max_tokens=200, 프롬프트별 모드별 5회입니다. Claude 토크나이저 기준 입력 토큰은 short 37, medium 9,112, long 70,398입니다. 60회 호출 중 오류와 스로틀은 없었고, needle 질문은 두 엔드포인트 모두 20회 중 20회 정답이었습니다.
비스트리밍 E2E 지연 (ms, 5회)
| 프롬프트 | 입력 토큰 | runtime p50 | runtime 평균 | runtime 최소~최대 | mantle p50 | mantle 평균 | mantle 최소~최대 | p50 차이 (mantle – runtime) |
|---|---|---|---|---|---|---|---|---|
| short | 37 | 908 | 926 | 778 ~ 1,119 | 772 | 812 | 763 ~ 914 | -135 (-15%) |
| medium | 9,112 | 1,068 | 1,081 | 943 ~ 1,212 | 1,023 | 989 | 782 ~ 1,098 | -46 (-4%) |
| long | 70,398 | 2,226 | 2,256 | 2,109 ~ 2,509 | 2,289 | 2,538 | 2,008 ~ 3,439 | +63 (+3%) |
스트리밍 TTFT와 E2E (ms, 5회)
| 프롬프트 | runtime TTFT p50 | runtime E2E p50 | runtime E2E 최소~최대 | mantle TTFT p50 | mantle E2E p50 | mantle E2E 최소~최대 | TTFT p50 차이 (mantle – runtime) |
|---|---|---|---|---|---|---|---|
| short | 881 | 938 | 922 ~ 1,546 | 565 | 817 | 648 ~ 828 | -315 (-36%) |
| medium | 829 | 1,159 | 932 ~ 1,416 | 824 | 1,140 | 960 ~ 1,176 | -6 (-1%) |
| long | 1,958 | 2,058 | 1,915 ~ 2,811 | 1,846 | 2,115 | 2,052 ~ 2,349 | -113 (-6%) |
출력 토큰 수, 스트리밍 청크 수, 출력 토큰 속도 (p50)
| 프롬프트 | runtime 출력 토큰 | mantle 출력 토큰 | runtime 청크 수 | mantle 청크 수 | runtime 토큰/초 | mantle 토큰/초 |
|---|---|---|---|---|---|---|
| short | 30 | 30 | 10 | 11 | 151 | 128 |
| medium | 26 | 26 | 11 | 12 | 110 | 119 |
| long | 25 | 26 | 11 | 12 | 113 | 115 |
결과에서 읽을 수 있는 것은 다음과 같습니다.
- medium 이상에서는 두 엔드포인트가 사실상 같은 곡선입니다. 비스트리밍 p50 차이가 -46ms와 +63ms, 스트리밍 TTFT 차이가 -6ms와 -113ms로, 모두 회차 간 편차(수백 ms) 안에 있습니다.
- short에서는 gpt-oss와 같은 경향이 다시 나타났습니다. 스트리밍 TTFT가 mantle 565ms, runtime 881ms로 mantle이 300ms 남짓 빨랐고, 비스트리밍도 135ms 빨랐습니다. 두 모델에서 같은 방향으로 반복된 유일한 차이입니다. 다만 표본이 5회이므로 “짧은 요청은 mantle이 빠르다”고 단정하기보다 “짧은 요청에서 mantle이 느리지는 않다” 정도로 읽는 것이 안전합니다.
- gpt-oss와 달리 청크가 9~16개로 나뉘어 왔고 출력 토큰 속도는 양쪽 모두 110~150 토큰/초로 같은 수준입니다. Claude에서는 스트리밍이 실제로 점진적으로 표시됩니다.
- runtime 쪽은
jp.지리적 추론 프로파일이라 요청이 오사카로 갈 수도 있는 조건이었는데도, 도쿄 in-region인 mantle과의 차이가 100ms 안팎이었습니다. 지리 프로파일의 라우팅 비용이 이 실험에서는 눈에 띄지 않았습니다.
응답 형식 차이
지연 수치와 별개로 응답 형식이 달랐던 점을 정리합니다.
| 항목 | bedrock-runtime | bedrock-mantle |
|---|---|---|
| gpt-oss 추론 과정 노출 | content 안에 <reasoning>...</reasoning> 태그로 포함 | content에 최종 답만 포함 |
gpt-oss 출력 토큰 수 (completion_tokens) | 추론 토큰 포함 | 추론 토큰 포함 (같은 값) |
| gpt-oss 정답률 (needle 찾기) | medium, long 모두 정답 | medium, long 모두 정답 |
| 요청 ID | x-request-id 헤더 | x-request-id 헤더 |
runtime의 <reasoning> 태그는 애플리케이션에서 파싱해 걷어내야 하므로, 사용자에게 보이는 첫 글자 기준 TTFT를 재려면 태그 이후의 텍스트를 기준으로 삼아야 합니다. 이번 측정의 TTFT는 태그를 포함한 첫 청크 기준이므로 runtime 쪽이 조금 유리하게 측정되었을 수 있습니다.
이 단계가 끝나면 “같은 엔진이라는 문서 설명이 실측에서도 성립하는가”에 대한 답을 갖게 됩니다.
Step 5. 긴 프롬프트 테스트 — 6만 토큰에서 무엇이 달라지나
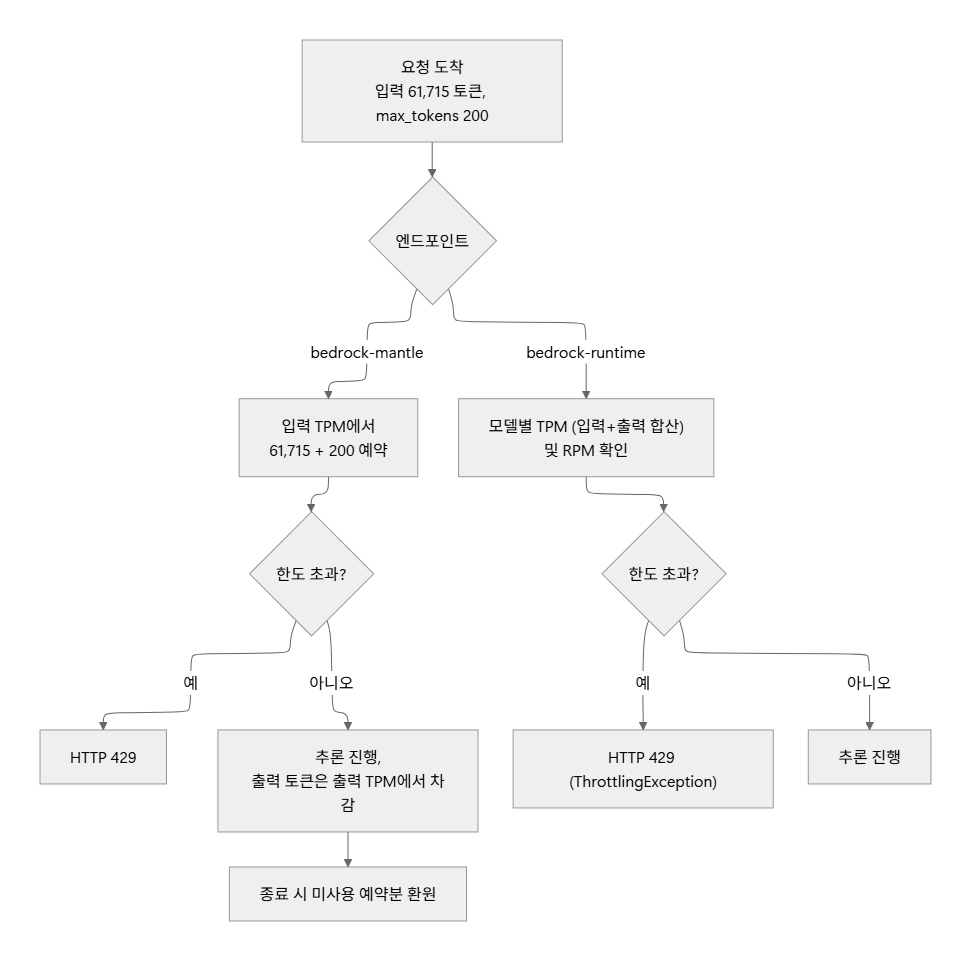
이 단계에서는 long 프롬프트(gpt-oss 기준 61,715 토큰, Claude 기준 70,398 토큰) 결과를 따로 봅니다. 긴 프롬프트는 프리필(입력 토큰 처리) 시간이 지배적이라 엔진 차이가 있다면 가장 크게 드러나는 구간이고, 동시에 쿼터 구조의 차이가 실제로 작동하는 구간입니다.
두 모델의 long 결과만 모아 보면 다음과 같습니다. 입력 토큰은 같은 텍스트를 각 모델의 토크나이저로 센 값입니다.
| 모델 | 입력 토큰 | 모드 | runtime p50 (ms) | mantle p50 (ms) | 차이 (mantle – runtime) | needle 정답 |
|---|---|---|---|---|---|---|
| gpt-oss-120b | 61,715 | 비스트리밍 E2E | 3,905 | 2,504 | -1,400 (-36%) | 10/10, 10/10 |
| gpt-oss-120b | 61,715 | 스트리밍 TTFT | 2,805 | 3,538 | +733 (+26%) | 10/10, 10/10 |
| Claude Haiku 4.5 | 70,398 | 비스트리밍 E2E | 2,226 | 2,289 | +63 (+3%) | 10/10, 10/10 |
| Claude Haiku 4.5 | 70,398 | 스트리밍 TTFT | 1,958 | 1,846 | -113 (-6%) | 10/10, 10/10 |
표에서 주목할 점은 세 가지입니다. 첫째, 6만~7만 토큰을 넣어도 두 엔드포인트 모두 2~4초 안에 첫 글자가 나왔고 정답률은 40회 모두 100%였습니다. 둘째, gpt-oss에서 두 모드의 차이 방향이 서로 반대인데, 이는 엔드포인트 간 차이가 아니라 회차 편차로 읽어야 합니다. 셋째, Claude에서는 in-region(mantle)과 지리적 추론 프로파일(runtime)의 차이가 100ms 안에 들어왔습니다. 긴 프롬프트에서 “어느 엔드포인트가 구조적으로 빠르다”는 신호는 이번 실측에서 나오지 않았습니다.
쿼터 관점에서는, 엔드포인트당 long 프롬프트 10회(gpt-oss 기준 약 62만 입력 토큰, Claude 기준 약 70만 입력 토큰)를 1분 남짓에 보냈는데 429나 503이 한 번도 없었습니다.
긴 프롬프트에서 쿼터가 어떻게 차감되는지는 엔드포인트마다 다릅니다. bedrock-mantle은 요청 시작 시 입력 토큰에 max_tokens를 더한 값을 입력 TPM 쿼터에서 예약하고, 응답이 끝나면 미사용분을 돌려줍니다. bedrock-runtime은 입력과 출력을 합산한 모델별 TPM 쿼터를 씁니다.
이번 사례에서 활용한 Bedrock Mantle 기능 정리
벤치마크 하나를 만들면서 실제로 사용한 기능을 단계별로 정리하면 다음과 같습니다.
| # | 기능 | 이번 사례에서의 활용 |
|---|---|---|
| 1 | Bedrock 장기 API 키 | 한 키로 두 엔드포인트를 모두 호출 |
| 2 | mantle 전용 IAM 액션 | mantle 호출 인가와 모델 목록 조회 |
| 3 | OpenAI 호환 Chat Completions API | gpt-oss-120b를 두 엔드포인트에서 같은 코드로 호출 |
| 4 | Anthropic Messages API | Claude Haiku 4.5를 두 엔드포인트에서 같은 코드로 호출 |
| 5 | Models API | mantle에서 사용 가능한 모델 ID 확인 |
| 6 | 스트리밍 응답 | TTFT와 출력 토큰 속도 측정 |
| 7 | mantle in-region 처리 | 크로스리전 없이 도쿄에서 처리 완결되는 조건으로 비교 |
| 8 | 엔드포인트별 분리 쿼터 | 긴 프롬프트 60회 호출 중 스로틀 없음 확인 |
결론
이번 실측으로 확인한 것은 “같은 엔진”이라는 문서 설명이 도쿄 리전에서 실제 숫자로도 성립하는지였습니다. 두 모델, 세 프롬프트 크기, 두 호출 모드로 총 120회를 호출한 결과, 두 엔드포인트의 p50 차이는 대부분 회차 간 편차 안에 있었고 방향도 일관되지 않았습니다. 6만~7만 토큰의 긴 프롬프트에서도 두 엔드포인트는 같은 속도 구간에 있었고 정답률은 모두 100%였습니다. 가장 반복적으로 보인 차이는 짧은 프롬프트의 TTFT에서 mantle이 300~400ms 빨랐던 것인데, 5회 표본이라 경향 이상으로 단정하기는 어렵습니다. 지금 bedrock-runtime으로 잘 돌아가는 서비스라면 속도 때문에 mantle로 옮길 이유는 이 실측에서 나오지 않았습니다.
따라서 엔드포인트 선택은 속도가 아니라 필요한 기능으로 정하면 됩니다. Guardrails, 지능형 프롬프트 라우팅, 크로스리전 추론, Bedrock 네이티브 API가 필요하면 bedrock-runtime이고, 서버 측 도구, 백그라운드 추론, Projects나 Workspaces 단위의 비용 추적, 또는 mantle에만 올라온 모델이 필요하면 bedrock-mantle입니다. 도입 전에는 두 엔드포인트의 IAM 액션과 쿼터가 완전히 분리되어 있다는 점, 그리고 mantle에는 아직 CloudWatch 지연 지표가 없다는 점을 확인하시기 바랍니다.
- Zero operator access design of Mantle: https://aws.amazon.com/blogs/machine-learning/exploring-the-zero-operator-access-design-of-mantle/
- Responses API (bedrock-mantle 지원 리전): https://docs.aws.amazon.com/bedrock/latest/userguide/bedrock-mantle.html
- Chat Completions API on bedrock-mantle: https://docs.aws.amazon.com/bedrock/latest/userguide/inference-chat-completions-mantle.html
- Anthropic Messages API: https://docs.aws.amazon.com/bedrock/latest/userguide/inference-messages-api.html
- Bedrock API keys: https://docs.aws.amazon.com/bedrock/latest/userguide/api-keys.html
- Quotas for the bedrock-mantle endpoint: https://docs.aws.amazon.com/bedrock/latest/userguide/quotas-mantle.html
- Scaling and throughput best practices: https://docs.aws.amazon.com/bedrock/latest/userguide/scaling-throughput-best-practices.html
- bedrock-mantle CloudWatch metrics: https://docs.aws.amazon.com/bedrock/latest/userguide/monitoring-mantle-metrics.html
글 | 메가존클라우드 Commercial Managed Unit 최영훈 매니저