켜기만 하면 프롬프트가 짧아질까? Amazon Bedrock 프롬프트 단축 기능 서울 리전 실측
켜기만 하면 프롬프트가 짧아질까? Amazon Bedrock 프롬프트 단축 기능 서울 리전 실측
AI 모델에 보내는 지시문(프롬프트)이 길수록 요금이 더 나오고, 답이 나오기 시작할 때까지 시간도 더 걸립니다. 2026년 10월 20일, Amazon Bedrock의 프롬프트 자동 개선 기능인 Advanced Prompt Optimization에 프롬프트 단축 옵션이 추가되었습니다. 원래 이 기능은 점수만 올리는 방향으로 프롬프트를 고쳐서, 결과가 오히려 길어지는 일이 많았습니다. 단축 옵션을 켜면 원래보다 짧으면서 점수도 떨어지지 않는 프롬프트만 돌려준다고 합니다. 그런 프롬프트를 찾지 못하면 원래 프롬프트가 그대로 돌아옵니다.
소개 글만 읽어서는 “정말 짧아지는지” 감이 오지 않아서, 서울 리전(ap-northeast-2)에서 직접 돌려보고 숫자로 확인했습니다. 기능 설명은 공식 문서에 잘 정리되어 있으므로, 이 글에서는 직접 해본 과정과 측정 결과를 정리했습니다.
실험에는 한국어 쇼핑몰 고객센터용 프롬프트 두 가지를 준비했습니다. 하나는 고객 문의를 종류별로 나누는 “분류” 프롬프트이고, 다른 하나는 쇼핑몰 정책을 보고 질문에 답하는 “답변” 프롬프트입니다. 단축 옵션을 켠 것과 끈 것을 나란히 세 번 돌렸고, 결과 프롬프트는 처음 보는 데이터로 다시 확인했습니다. 어떤 기능을 어디에 썼는지는 글 마지막에 표로 정리해두었습니다.
결과를 먼저 말씀드리면, 1차와 2차에서는 옵션을 켠 10번 모두 프롬프트가 하나도 줄지 않았습니다. 업무와 상관없는 문단을 일부러 넣은 3차에서야 프롬프트가 줄었고, 실제 입력 토큰을 최대 31.1%까지 줄일 수 있었습니다.
테스트를 어떻게 설계했나
단축 옵션의 효과를 보려면 다른 조건은 다 같고 옵션만 다른 비교가 필요했습니다. 그래서 같은 프롬프트를 한 작업 안에 두 번 넣고, 하나에만 단축 옵션을 켰습니다. 옵션은 프롬프트마다 따로 켜고 끌 수 있어서 이런 비교가 가능했습니다.
채점 방식은 두 가지로 나눴습니다. 분류는 정답이 딱 정해져 있어서, 직접 짠 코드로 맞았는지 틀렸는지를 셌습니다. 답변은 정답 문장이 하나로 정해지지 않아서 AI 모델에게 채점을 맡겼습니다.
세 번의 실행은 다음과 같이 구성했습니다.
| 차수 | 테스트한 모델 | 넣은 프롬프트 | 이렇게 바꾼 이유 |
|---|---|---|---|
| 1차 | Haiku 4.5 | 긴 분류 프롬프트(옵션 끔, 켬), 긴 답변 프롬프트(끔, 켬), 짧은 분류 프롬프트(켬) | 기본 동작 확인 |
| 2차 | Haiku 4.5, Nova 2 Lite | 분류(끔, 켬, 일부 보호 후 켬, 어려운 문의 10건 추가), 답변(끔, 켬, AI 채점 기준 직접 작성) | 1차에서 하나도 안 줄어서 조건을 바꿔봄 |
| 3차 | Haiku 4.5, Nova 2 Lite | 군더더기 문단을 넣은 분류(끔, 켬)와 답변(끔, 켬), 분류 채점에서 형식 감점 제거 | 2차도 하나도 안 줄어서, 지워도 되는 문단이 확실한 프롬프트로 재시도 |
차수마다 여러 조건을 한꺼번에 바꿨기 때문에, 차수 사이의 차이를 한 가지 원인으로 단정하지는 않았습니다. 대신 같은 작업 안에서 옵션만 다르게 넣은 쌍끼리는 그대로 비교했습니다.
작업 하나가 돌아가는 순서를 그려보면 다음과 같습니다.
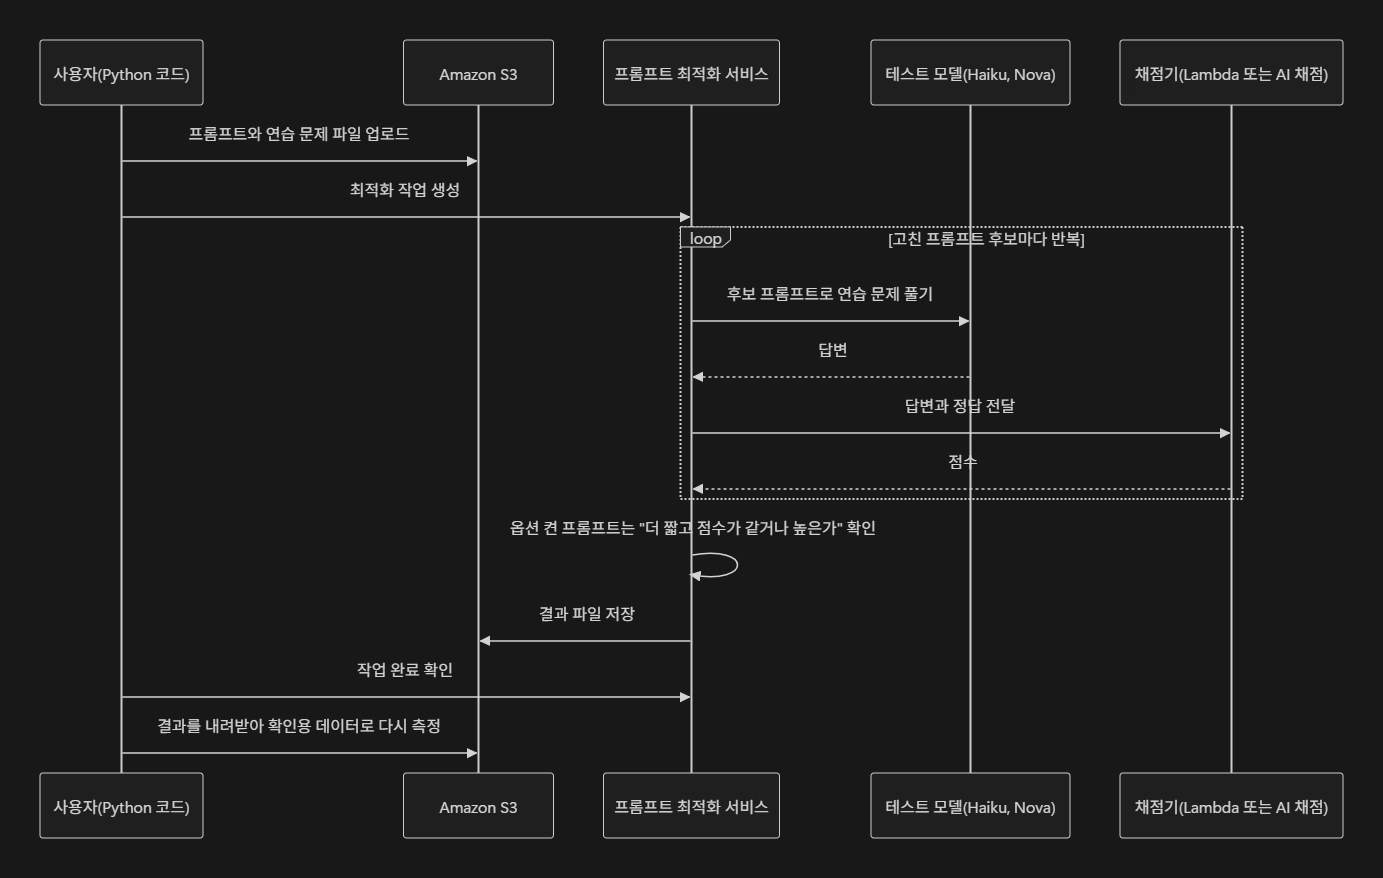
문서를 보니 단축 옵션을 켜도 채점 방식은 그대로라고 나와 있었습니다. 길이는 서비스가 따로 재고, 채점기는 평소처럼 답변만 봅니다.
Step 1. 준비: SDK 버전부터 확인했습니다
가장 먼저 서울 리전에서 이 기능을 부를 수 있는지 확인했습니다. 새로 나온 기능이라 개발 도구가 옛 버전이면 기능 자체가 없을 수 있기 때문입니다.
기존 환경을 건드리지 않으려고 별도 가상환경을 만들고 최신 boto3를 설치했습니다.
python -m venv venv
./venv/Scripts/python -m pip install --upgrade boto3   # 1.43.118 설치됨
./venv/Scripts/python -c "import boto3; c=boto3.client('bedrock', region_name='ap-northeast-2'); \
print([m for m in dir(c) if 'advanced' in m])"
설치 후에는 아래 다섯 개 함수가 보였습니다. 삭제 함수 이름이 문서 예시와 달리 끝에 s가 없다는 점도 이때 알게 되었습니다.
python -m venv venv
./venv/Scripts/python -m pip install --upgrade boto3   # 1.43.118 설치됨
./venv/Scripts/python -c "import boto3; c=boto3.client('bedrock', region_name='ap-northeast-2'); \
print([m for m in dir(c) if 'advanced' in m])"
작업을 만드는 요청을 살펴보니 서비스용 IAM 역할을 넘기는 항목이 없었습니다. 역할이나 버킷 정책을 따로 만들지 않았는데도, 같은 계정의 S3 버킷을 읽고 쓰는 데 문제가 없었습니다. 그 대신 모델별로 답변 설정을 줄 수 있어서, 매번 같은 답이 나오도록 temperature: 0.0, maxTokens: 512로 고정했습니다.
준비하면서 막혔던 지점은 다음과 같습니다.
| 겪은 증상 | 원인 | 해결한 방법 |
|---|---|---|
CLI에서 invalid choice 오류 | CLI가 옛 버전 | 최신 boto3로 진행 |
| boto3에 함수가 없음 | boto3 1.43.2 | pip install --upgrade boto3로 1.43.118 설치 |
문서대로 batch_delete_..._jobs를 쓰면 오류 | 실제 이름은 s가 없는 단수형 | batch_delete_advanced_prompt_optimization_job 사용 |
이 단계를 마치고 나서 서울 리전에서 작업을 만들 준비가 끝났습니다.
Step 2. 입력 파일과 채점기를 만들었습니다
다음으로 최적화할 프롬프트와 연습 문제를 파일 하나에 담고, 분류 답변을 채점할 Lambda 함수를 만들었습니다. 단축 옵션은 콘솔 버튼이나 API 설정이 아니라 이 입력 파일 안에서만 켤 수 있었습니다. 그래서 사실상 이 파일을 만드는 것이 설정의 전부였습니다.
입력 파일은 한 줄에 프롬프트 하나를 적는 JSONL 형식입니다. 아래는 분류 프롬프트에 단축 옵션을 켠 한 줄을 보기 좋게 펼친 것입니다(프롬프트 내용과 연습 문제는 줄여서 적었습니다).
{
  "version": "bedrock-2026-05-14",
  "templateId": "r3-cls-fluff-shorten",
  "promptTemplate": "당신은 국내 대형 온라인 쇼핑몰 '모아마켓'의 ... ## 분류할 고객 문의\n\n{{ticket}}",
  "optimizationConfig": { "shortenPrompt": true },
  "customEvaluationMetricLabel": "cls_field_accuracy",
  "evaluationMetricLambdaArn": "arn:aws:lambda:ap-northeast-2:<ACCOUNT_ID>:function:apo-shorten-blog-eval",
  "evaluationSamples": [
    {
      "inputVariables": [{ "ticket": "어제 주문한 이어폰 결제가 두 번 됐어요. 빨리 취소해주세요." }],
      "referenceResponse": "{\"category\": \"BILLING\", \"priority\": \"P1\"}"
    }
  ]
}
핵심은 "optimizationConfig": { "shortenPrompt": true } 한 줄이었습니다. 비교용으로 옵션을 끈 줄은 templateId만 다르게 하고 이 한 줄을 뺐습니다.
분류 채점기는 모델 답에서 “문의 종류(category)”와 “급한 정도(priority)”가 정답과 같은지 확인하도록 만들었습니다. 종류가 맞으면 0.6점, 급한 정도가 맞으면 0.4점을 주고, 둘 다 맞으면 1.0점입니다. 문서에 서비스가 채점 코드와 설명 주석을 읽고 프롬프트 개선에 참고한다고 나와 있어서, 채점 기준을 주석에 분명히 적었습니다.
def compute_score(preds, golds):
    """
    Score = 0.6 * (category matches) + 0.4 * (priority matches), per sample.
    Unparseable output scores 0.0. Text around the JSON (such as code fences) is ignored.
    """
    scores = []
    for pred, gold in zip(preds, golds):
        p, g = _parse(pred), _parse(gold)          # 답변에서 JSON 부분만 꺼냄
        if p is None or g is None:
            scores.append(0.0); continue
        s = 0.6 * (p.get("category", "").upper() == g["category"])
        s += 0.4 * (p.get("priority", "").upper() == g["priority"])
        scores.append(round(s, 3))
    return {"score": sum(scores) / len(scores) if scores else 0.0, "scores": scores}
1차와 2차에서는 답을 ““` 기호로 감싸는 등 JSON 바깥에 글이 붙으면 0.1점을 깎았고, 3차에서는 위 코드처럼 이 감점을 뺐습니다.
함수를 배포한 뒤에는 Bedrock이 이 함수를 부를 수 있도록 권한을 줬습니다. 문서에 이 권한이 꼭 필요하다고 나와 있었습니다.
aws lambda add-permission --function-name apo-shorten-blog-eval --statement-id bedrock-apo \
  --action lambda:InvokeFunction --principal bedrock.amazonaws.com --source-account <ACCOUNT_ID> \
  --region ap-northeast-2
이번에 써본 채점 방식 네 가지를 정리하면 다음과 같습니다.
| 채점 방식 | 입력 파일에 적은 항목 | 쓴 곳 | 써보니 |
|---|---|---|---|
| 직접 짠 코드 (Lambda) | evaluationMetricLambdaArn | 분류 전체 | 같은 답에는 항상 같은 점수가 나옴 |
| 원하는 방향 키워드 (steering criteria) | steeringCriteria: ["ACCURATE", "CONCISE", ...] | 1차 답변 | “정확하게, 간결하게” 같은 짧은 기준만 줌 |
| AI 채점 기준 직접 작성 | customLLMJConfig | 2차 답변 | 채점 지시문을 직접 쓰고 Sonnet 4.6이 채점 |
| 기본 채점 | 채점 항목을 모두 비워둠 | 3차 답변 | Sonnet 4.6이 정확성, 빠짐없음, 간결함을 채점 |
이 단계를 마치니 옵션을 켠 프롬프트와 끈 프롬프트가 함께 담긴 입력 파일이 준비되었습니다.
Step 3. 최적화 작업을 실행했습니다
입력 파일을 S3에 올리고 작업을 만들었습니다. 단축 옵션을 켰다고 해서 작업을 만드는 코드가 달라지지는 않았습니다.
아래는 3차 작업을 만들 때 쓴 코드입니다. 모델을 두 개 적었더니 프롬프트마다 모델별로 따로 최적화되었습니다.
import boto3
bedrock = boto3.client("bedrock", region_name="ap-northeast-2")
ic = {"temperature": 0.0, "maxTokens": 512}
job = bedrock.create_advanced_prompt_optimization_job(
    jobName="apo-shorten-blog-job-r3",
    modelConfigurations=[
        {"modelId": "global.anthropic.claude-haiku-4-5-20251001-v1:0", "inferenceConfig": ic},
        {"modelId": "global.amazon.nova-2-lite-v1:0", "inferenceConfig": ic},
    ],
    inputConfig={"s3Uri": "s3://<BUCKET>/input/dataset_r3.jsonl"},
    outputConfig={"s3Uri": "s3://<BUCKET>/output/"},
)
status = bedrock.get_advanced_prompt_optimization_job(jobIdentifier=job["jobArn"])["jobStatus"]
작업 상태는 InProgress(진행 중)였다가 Completed(완료)로 바뀌었습니다. 실제로 걸린 시간은 다음과 같았습니다.
| 차수 | 프롬프트 수 x 모델 수 | 걸린 시간 |
|---|---|---|
| 1차 | 5 x 1 = 5 | 약 16분 50초 |
| 2차 | 5 x 2 = 10 | 약 15분 5초 |
| 3차 | 4 x 2 = 8 | 약 15분 29초 |
세 작업 모두 15~17분 사이에 끝났습니다. 결과는 output/<작업 ID>/advanced_prompt_optimization_results.jsonl 파일로 저장되었습니다. 작업을 시작하자 출력 폴더에 tmp-permission-check-file이라는 빈 파일도 함께 생겼습니다. 이 파일 경로에는 output//aws/...처럼 슬래시가 두 번 들어가 있어서, Windows에서 aws s3 cp --recursive로 폴더째 받았더니 이 파일에서 다운로드가 실패했습니다. 그래서 결과 파일 경로를 직접 적어서 받았습니다. 결과 파일에서 필요한 숫자만 꺼낼 때는 다음 코드를 썼습니다.
import json
for line in open("results_r3.jsonl", encoding="utf-8"):
    r = json.loads(line)
    for o in r["promptOptimizationResults"]:
        print(r["promptTemplateId"], o["modelId"],
              o.get("compressionRatio"), o.get("originalTokenCount"), o.get("optimizedTokenCount"),
              o["originalPromptMetrics"]["averageScore"], o["optimizedPromptMetrics"]["averageScore"])
compressionRatio(남은 길이 비율), originalTokenCount(원래 토큰 수), optimizedTokenCount(줄인 뒤 토큰 수)는 단축 옵션을 켠 프롬프트에만 나왔습니다. 이 단계까지 마치니 프롬프트와 모델 조합마다 얼마나 줄었는지, 점수는 어떻게 바뀌었는지 비교할 수 있었습니다.
Step 4. 1차와 2차: 옵션을 켰는데 하나도 안 줄었습니다
1차와 2차에서 옵션을 켠 10개 조합은 모두 남은 길이 비율이 1.0이었습니다. 원래 프롬프트가 그대로 돌아온 것입니다. 이유를 찾으려고 문서를 다시 읽어 보니, 서비스가 결과를 돌려주는 기준이 다음과 같았습니다.
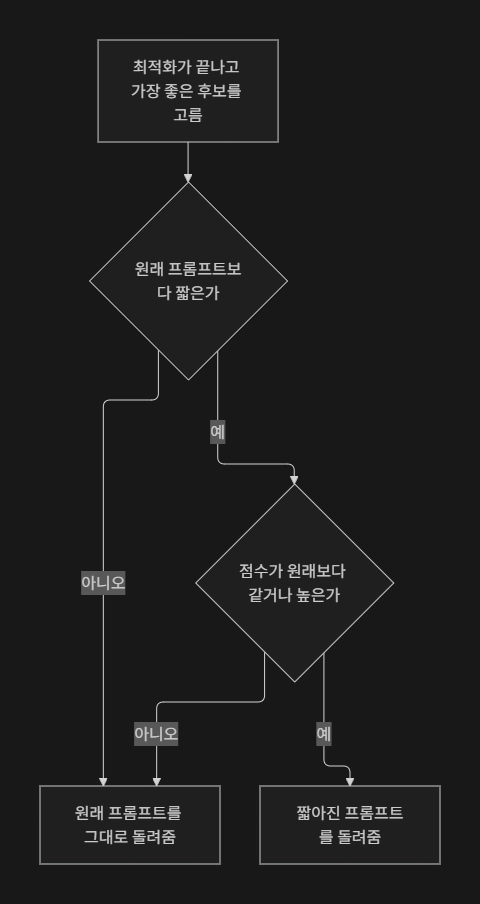
두 조건을 모두 통과해야 짧아진 프롬프트를 받을 수 있습니다. 원래 프롬프트가 이미 모든 문제를 맞혔다면, 짧은 후보도 모든 문제를 맞혀야 통과합니다.
1차와 2차 결과는 다음과 같았습니다. 점수는 높을수록 좋습니다.
| 차수 | 프롬프트 | 모델 | 단축 옵션 | 남은 길이 | 점수 (전 → 후) |
|---|---|---|---|---|---|
| 1차 | 긴 분류 | Haiku 4.5 | 켬 | 100% (그대로) | 1.0 → 1.0 |
| 1차 | 긴 답변 | Haiku 4.5 | 켬 | 100% (그대로) | 0.905 → 0.905 |
| 1차 | 짧은 분류 | Haiku 4.5 | 켬 | 100% (그대로) | 0.88 → 0.88 |
| 2차 | 분류 30건 | Haiku 4.5 | 켬 | 100% (그대로) | 1.0 → 1.0 |
| 2차 | 분류 30건 | Nova 2 Lite | 켬 | 100% (그대로) | 0.86 → 0.86 |
| 2차 | 분류, 출력 형식 부분 보호 | 두 모델 | 켬 | 100% (그대로) | 변화 없음 |
| 2차 | 답변 | Haiku 4.5 | 켬 | 100% (그대로) | 0.887 → 0.887 |
| 2차 | 답변 | Nova 2 Lite | 켬 | 100% (그대로) | 0.573 → 0.573 |
| 2차 | 답변 | Nova 2 Lite | 끔 | 오히려 길어짐 | 0.572 → 0.782 |
결과를 살펴보며 알게 된 점은 세 가지입니다.
첫째, 원래 프롬프트가 모든 문제를 맞힌 경우에는 통과 조건이 까다로웠습니다. Haiku 4.5는 긴 분류 프롬프트로 30문제를 모두 맞혔기 때문에, 짧은 후보도 30문제를 모두 맞혀야 했습니다. 채점 함수 기록을 확인해 보니 서비스가 후보를 여러 번 채점한 흔적이 있었습니다(1차 68번, 2차 136번). 그래도 통과한 후보는 없었습니다. 다만 0.86점이던 Nova 2 Lite 분류도 그대로 돌아왔으므로, 만점이었다는 것만으로는 설명되지 않았습니다.
둘째, 처음부터 짧은 프롬프트는 줄지 않았습니다. 238토큰짜리 짧은 분류 프롬프트는 문서에서 설명한 대로 그대로 돌아왔습니다.
셋째, 옵션을 끄면 프롬프트가 길어지는 경우를 실제로 봤습니다. 옵션을 끈 Nova 2 Lite 답변에서는 “인사말로 시작하지 말 것, 맺음말을 쓰지 말 것”이라는 규칙이 새로 붙었습니다. 프롬프트는 1,039자에서 1,129자로 늘었고, 모델에 들어가는 토큰도 평균 917개에서 977개로 늘었습니다. 그 대신 점수는 0.572에서 0.782로 올랐고, 답변 길이는 109토큰에서 35토큰, 112토큰에서 46토큰처럼 짧아졌습니다. 이 기능이 나온 이유인 “점수는 오르지만 프롬프트는 길어지는” 현상을 직접 확인한 셈입니다.
출력 형식 부분을 <advpo:exclude> 태그로 감싸 고치지 못하게 막아둔 프롬프트도 확인했습니다. 토큰 수가 태그 없는 프롬프트와 같은 2,308개로 집계되어, 문서 설명대로 태그 자체는 길이 계산에서 빠진다는 것을 확인했습니다.
2차까지 옵션을 켠 조합이 하나도 줄지 않아서, 다음에는 지워도 되는 문단이 확실히 들어 있는 프롬프트로 다시 시도했습니다.
Step 5. 3차: 쓸데없는 문단을 넣었더니 줄었습니다
이번에는 업무와 상관없는 문단을 일부러 넣었습니다. 지워도 결과에 영향이 없어야 할 문단이 분명히 있을 때 옵션이 제대로 작동하는지 보고 싶었습니다.
분류 프롬프트에는 “모아마켓 소개”, “고객센터 운영 철학”, “다시 한번 정리하는 핵심 규칙”, “자주 하는 실수” 네 문단을 넣어 2,859자를 4,145자로 늘렸습니다. 답변 프롬프트에는 앞의 두 문단만 넣어 1,039자를 1,692자로 늘렸습니다. 결과는 다음과 같았습니다.
| 프롬프트 | 모델 | 단축 옵션 | 남은 길이 | 모델에 들어간 평균 토큰 | 점수 (전 → 후) |
|---|---|---|---|---|---|
| 분류 | Haiku 4.5 | 켬 | 90.6% (3,456 → 3,132) | 3,935 → 3,601 | 0.987 → 1.0 |
| 분류 | Haiku 4.5 | 끔 | – | 3,935 → 3,263 | 0.987 → 1.0 |
| 분류 | Nova 2 Lite | 켬 | 100% (그대로) | 2,308 → 2,308 | 0.947 → 0.947 |
| 답변 | Haiku 4.5 | 켬 | 60.3% (1,626 → 980) | 2,157 → 1,485 | 0.898 → 0.925 |
| 답변 | Nova 2 Lite | 켬 | 80.8% (1,626 → 1,314) | 1,309 → 1,124 | 0.642 → 0.695 |
| 답변 | Nova 2 Lite | 끔 | – | 1,309 → 1,309 (그대로) | 0.585 → 0.657 |
드디어 옵션을 켠 4개 조합 중 3개가 줄었습니다. 가장 많이 준 Haiku 4.5 답변은 원래 길이의 60.3%만 남았고, 점수는 오히려 조금 올랐습니다.
무엇이 지워졌는지 원래 프롬프트와 한 줄씩 비교해 봤습니다. 문장을 다듬은 것이 아니라 상관없는 문단을 통째로 지웠습니다.
| 조합 | 지워진 것 | 남은 것 |
|---|---|---|
| 답변, Haiku 4.5 | “모아마켓 소개”, “고객센터 운영 철학” 두 문단 전부 | 문단을 넣기 전 원래 프롬프트(1,039자)와 글자 하나까지 같아짐 |
| 답변, Nova 2 Lite | “모아마켓 소개”의 본문 (제목 줄은 빈 채로 남음) | 운영 철학 문단은 남음 |
| 분류, Haiku 4.5 (켬) | “모아마켓 소개” 문단 | 운영 철학, 핵심 규칙 요약, 자주 하는 실수는 남음 |
| 분류, Haiku 4.5 (끔) | “모아마켓 소개”, “고객센터 운영 철학” 두 문단 | 핵심 규칙 요약, 자주 하는 실수는 남음 |
이 결과에서 눈에 띈 점이 세 가지 있었습니다.
첫째, 옵션을 끈 쪽이 더 짧아진 경우도 있었습니다. 분류 Haiku에서 옵션을 끈 결과는 3,263토큰으로, 옵션을 켠 결과(3,601토큰)보다 짧았습니다. 문서에는 단축이 한 번에 크게 자르지 않고 조금씩 줄여 나간다고 나와 있습니다. 옵션을 끄면 길이 제한이 없어질 뿐, 짧아지는 것을 막지는 않습니다. 결국 단축 옵션이 약속하는 것은 “원래보다 길어지지 않는다”는 것이고, “몇 토큰까지 줄여라” 같은 목표는 정할 수 없었습니다.
둘째, AI 채점 점수는 같은 프롬프트라도 흔들렸습니다. 옵션을 끈 Nova 2 Lite 답변은 프롬프트가 한 글자도 바뀌지 않았는데 점수가 0.585에서 0.657로 바뀌었습니다. AI가 채점할 때 점수 차이가 작게 나왔다면, 한 번 더 돌려서 확인하는 편이 좋겠습니다.
셋째, 같은 프롬프트라도 모델마다 토큰 수가 달랐습니다. 군더더기를 넣은 분류 프롬프트는 Haiku 4.5에서 3,935토큰, Nova 2 Lite에서 2,308토큰으로 셌습니다. 그런데 결과 파일의 원래 토큰 수(originalTokenCount)는 두 모델 모두 3,456으로 같았습니다. 결과 파일의 “남은 길이”가 곧 요금 절감률은 아니어서, 실제 절감률은 쓰는 모델로 직접 재봐야 했습니다.
이 단계까지 해서 짧아진 프롬프트 3개를 얻었습니다. 다음 단계에서는 이 프롬프트가 처음 보는 문제에서도 잘 작동하는지 확인했습니다.
Step 6. 처음 보는 데이터로 다시 확인했습니다
최적화에 쓴 연습 문제에서만 점수가 좋을 수도 있어서, 따로 남겨둔 확인용 데이터로 다시 재봤습니다. 문서에서도 이 확인을 권장하고 있습니다.
측정은 모델을 직접 호출하는 Converse API로 했습니다. 모델에 들어간 토큰 수는 응답의 usage.inputTokens에서, 걸린 시간은 metrics.latencyMs에서 가져왔습니다.
r = rt.converse(modelId=MODEL,
                messages=[{"role": "user", "content": [{"text": template.replace("{{ticket}}", ticket)}]}],
                inferenceConfig={"temperature": 0.0, "maxTokens": 512})
tokens, latency = r["usage"]["inputTokens"], r["metrics"]["latencyMs"]
측정하기 전에 바로잡아야 할 것이 하나 있었습니다. 결과 파일 속 프롬프트를 열어 보니 JSON 예시의 중괄호가 {"category": ...}가 아니라 {{"category": ...}}처럼 두 번씩 적혀 있었습니다. 이대로 쓰면 모델이 이상한 예시를 보게 됩니다. 그래서 {{ticket}}처럼 값을 바꿔 끼우는 자리만 남기고, 나머지 중괄호는 한 번씩으로 되돌린 뒤 측정했습니다.
분류는 확인용 문의 30건을 Haiku 4.5로 3번씩 돌렸습니다.
| 프롬프트 | 모델에 들어간 평균 토큰 | 줄어든 양 | 점수 | 완전히 맞힌 문의 |
|---|---|---|---|---|
| 군더더기 넣은 원래 프롬프트 | 3,929.4 | – | 0.973 | 28/30 |
| 옵션 켜고 줄인 프롬프트 | 3,596.4 | 8.5% | 0.973 | 28/30 |
| 옵션 끄고 고친 프롬프트 | 3,258.4 | 17.1% | 0.973 | 28/30 |
토큰은 줄었는데 정답률은 셋 다 같았습니다. 틀린 두 건도 같은 문의(“반품 수거가 3일째 안 오고 있어요”, “반품 신청은 4일 전에 했어요”)였고, 셋 다 급한 정도를 P3가 아닌 P2로 골랐습니다. 걸린 시간은 줄인 프롬프트 쪽이 조금 짧게 나왔습니다. 하지만 네트워크 상태를 통제하지 않은 한 번의 측정이라서, 속도가 빨라졌다고 판단하지는 않았습니다.
답변은 최적화에 쓰지 않은 새 질문 6개를 만들어 3번씩 돌렸습니다. 첫 번째 답변은 Sonnet 4.6에게 정책, 정답, 답변을 주고 1~5점으로 채점하게 했습니다.
| 모델 | 프롬프트 | 모델에 들어간 평균 토큰 | 줄어든 양 | 채점 평균 (5점 만점) |
|---|---|---|---|---|
| Haiku 4.5 | 원래 프롬프트 | 2,160.2 | – | 3.83 |
| Haiku 4.5 | 줄인 프롬프트 | 1,488.2 | 31.1% | 4.17 |
| Nova 2 Lite | 원래 프롬프트 | 1,311.7 | – | 3.50 |
| Nova 2 Lite | 줄인 프롬프트 | 1,126.7 | 14.1% | 4.00 |
두 모델 모두 토큰이 줄었고, 채점 점수도 떨어지지 않았습니다. Haiku 4.5 기준으로 한 번 부를 때마다 약 672토큰이 줄었으니, 하루 100만 번 부른다면 하루 약 6.7억 토큰을 아낄 수 있는 셈입니다. 다만 질문이 6개뿐이고 채점도 한 번만 했으므로, 점수가 오른 것은 “떨어지지 않았다” 정도로 받아들였습니다.
해본 과정을 순서도로 정리하면 다음과 같습니다.
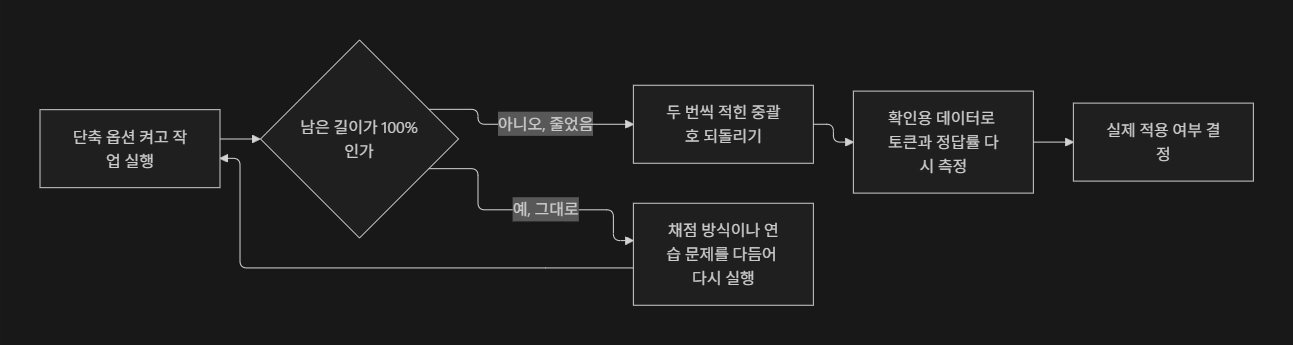
이번 사례에서 활용한 Advanced Prompt Optimization 기능 정리
세 번의 최적화와 확인 측정에서 실제로 쓴 기능을 정리하면 다음과 같습니다.
| # | 기능 | 이번 사례에서 한 일 | 관련 명령 및 설정 |
|---|---|---|---|
| 1 | 프롬프트 단축 옵션 | 같은 프롬프트를 옵션 켬과 끔으로 나란히 넣어 비교 | "optimizationConfig": {"shortenPrompt": true} |
| 2 | 줄어든 길이 정보 | 얼마나 줄었는지 확인 | compressionRatio, originalTokenCount, optimizedTokenCount |
| 3 | 결과 반환 기준 | 1차, 2차에서 그대로 돌아온 결과 이해 | 더 짧고 점수가 같거나 높을 때만 줄인 프롬프트 반환 |
| 4 | Lambda 채점기 | 분류 정답 여부 채점 | evaluationMetricLambdaArn, compute_score(preds, golds) |
| 5 | 방향 키워드 채점 | 1차 답변 채점 | "steeringCriteria": ["ACCURATE", "CONCISE", ...] |
| 6 | AI 채점 기준 직접 작성 | 2차 답변을 Sonnet 4.6으로 채점 | customLLMJConfig.customLLMJModelId: "anthropic.claude-sonnet-4-6" |
| 7 | 기본 채점 | 3차 답변 채점 | 채점 항목을 모두 비워둠 |
| 8 | 일부 구간 보호 | 출력 형식 부분을 못 고치게 막고, 태그가 길이 계산에서 빠지는지 확인 | <advpo:exclude> ... </advpo:exclude> |
| 9 | 여러 모델 한 번에 최적화 | Haiku 4.5와 Nova 2 Lite를 한 작업에서 비교 | modelConfigurations에 모델 2개, inferenceConfig |
| 10 | 작업 관리 | 작업 생성, 상태 확인, 목록 조회, 삭제 | create_, get_, list_, batch_delete_advanced_prompt_optimization_job |
결론
이번 테스트에서 프롬프트 단축은 “프롬프트를 항상 짧게 만들어 주는 기능”이라기보다 “결과가 원본보다 길어지거나 점수가 떨어지지 않게 막아 주는 조건”으로 동작했습니다. 1차와 2차에서 긴 분류 프롬프트와 답변 프롬프트는 단축을 켜도 원본 그대로 돌아왔습니다. 반면 회사 소개나 운영 철학처럼 업무와 무관한 문단을 덧붙인 3차 프롬프트에서는 그 문단을 걷어내 확인용 데이터 기준 입력 토큰을 최대 31.1% 줄였고, 측정한 범위에서 품질도 떨어지지 않았습니다.
업무와 무관한 문단이 쌓인 시스템 프롬프트를 대량 호출에 쓰고 있다면 시도해 볼 만합니다. 입력 파일에 optimizationConfig 한 줄만 더하면 되고, 이번 작업은 각각 15~17분 만에 끝났습니다. 반대로 이번 1차의 짧은 프롬프트처럼 이미 짧은 프롬프트는 그대로 돌아왔습니다. 도입 전에는 두 가지를 확인하시기 바랍니다. 하나는 채점 방식과 연습 문제가 지켜야 할 품질을 충분히 반영하는지이고, 다른 하나는 결과 프롬프트의 두 번씩 적힌 중괄호를 되돌리는 배포 절차가 있는지입니다.
먼저 운영 중인 프롬프트 하나를 단축을 켠 것과 끈 것으로 나란히 돌려보며 시작해보시기 바랍니다.
- 출시 소식(What’s New): https://aws.amazon.com/ko/about-aws/whats-new/2026/10/bedrock-prompt-optimization-shortening
- 프롬프트 단축 문서: https://docs.aws.amazon.com/bedrock/latest/userguide/advanced-prompt-optimization-shorten.html
- 입력 파일 작성 문서: https://docs.aws.amazon.com/bedrock/latest/userguide/advanced-prompt-optimization-input.html
- 채점 방식 문서: https://docs.aws.amazon.com/bedrock/latest/userguide/advanced-prompt-optimization-evaluation.html
- 지원 리전, 모델, 한도: https://docs.aws.amazon.com/bedrock/latest/userguide/advanced-prompt-optimization-quotas.html
- 예제 노트북(GitHub): https://github.com/aws-samples/amazon-bedrock-samples/tree/main/advanced-prompt-optimization
글 | 메가존클라우드 Commercial Managed Unit 최영훈 매니저